产品简介
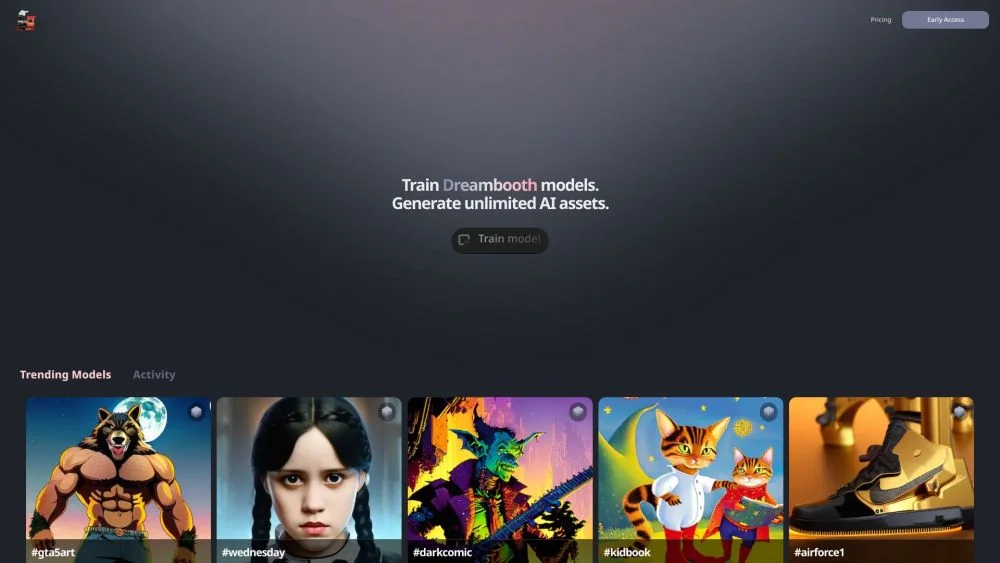
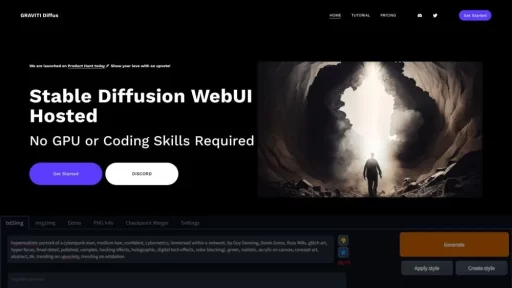
Diffus 是一款基于浏览器的专业 AI 图像生成平台,旨在降低高质量视觉创作的技术门槛。该平台依托云端算力,用户无需配备昂贵的本地 GPU 硬件即可直接进行图像生成与处理。通过整合庞大的模型生态与先进的控制算法,Diffus 为创作者提供了从基础出图到精细调控的一站式解决方案。
平台内置了超过 70,000 个预置模型资源,涵盖各类检查点(Checkpoint)及 LoRA 插件,并深度集成了 ComfyUI 工作流引擎。无论是追求快速生成的普通用户,还是需要复杂节点控制的进阶创作者,都能在此找到匹配的工作方式,实现高效且可控的创意产出。
主要功能
- 海量模型库:提供逾 70,000 个 AI 模型资源,支持自定义模型的上传、管理与调用
- 精细化构图控制:集成 ControlNet 技术,允许用户对画面结构、姿态及细节进行精准引导
- 高级面部增强:内置 ADetailer 及面部修复算法,显著提升人物面部的清晰度与自然度
- 浏览器端直连:基于 Web 环境运行,免除本地部署与硬件配置烦恼
- ComfyUI 集成:原生支持 ComfyUI 工作流,满足高阶用户的定制化流程需求
- 多媒体生成能力:支持文本生成视频以及视频换脸等扩展性应用
- 隐私与分享管理:生成的图像及使用的模型支持私密存储或公开共享
应用场景
- 数字艺术创作:设计师利用丰富的模型库和 ControlNet 快速生成概念图、插画及海报素材
- 人像摄影后期:通过面部增强和修复功能,优化肖像照片细节,提升画质表现
- 短视频内容制作:结合视频生成与换脸技术,辅助创作者快速制作特效视频内容
- 个性化工作流搭建:专业用户借助 ComfyUI 集成模块,构建复杂的自动化图像处理流水线