AI工具大全
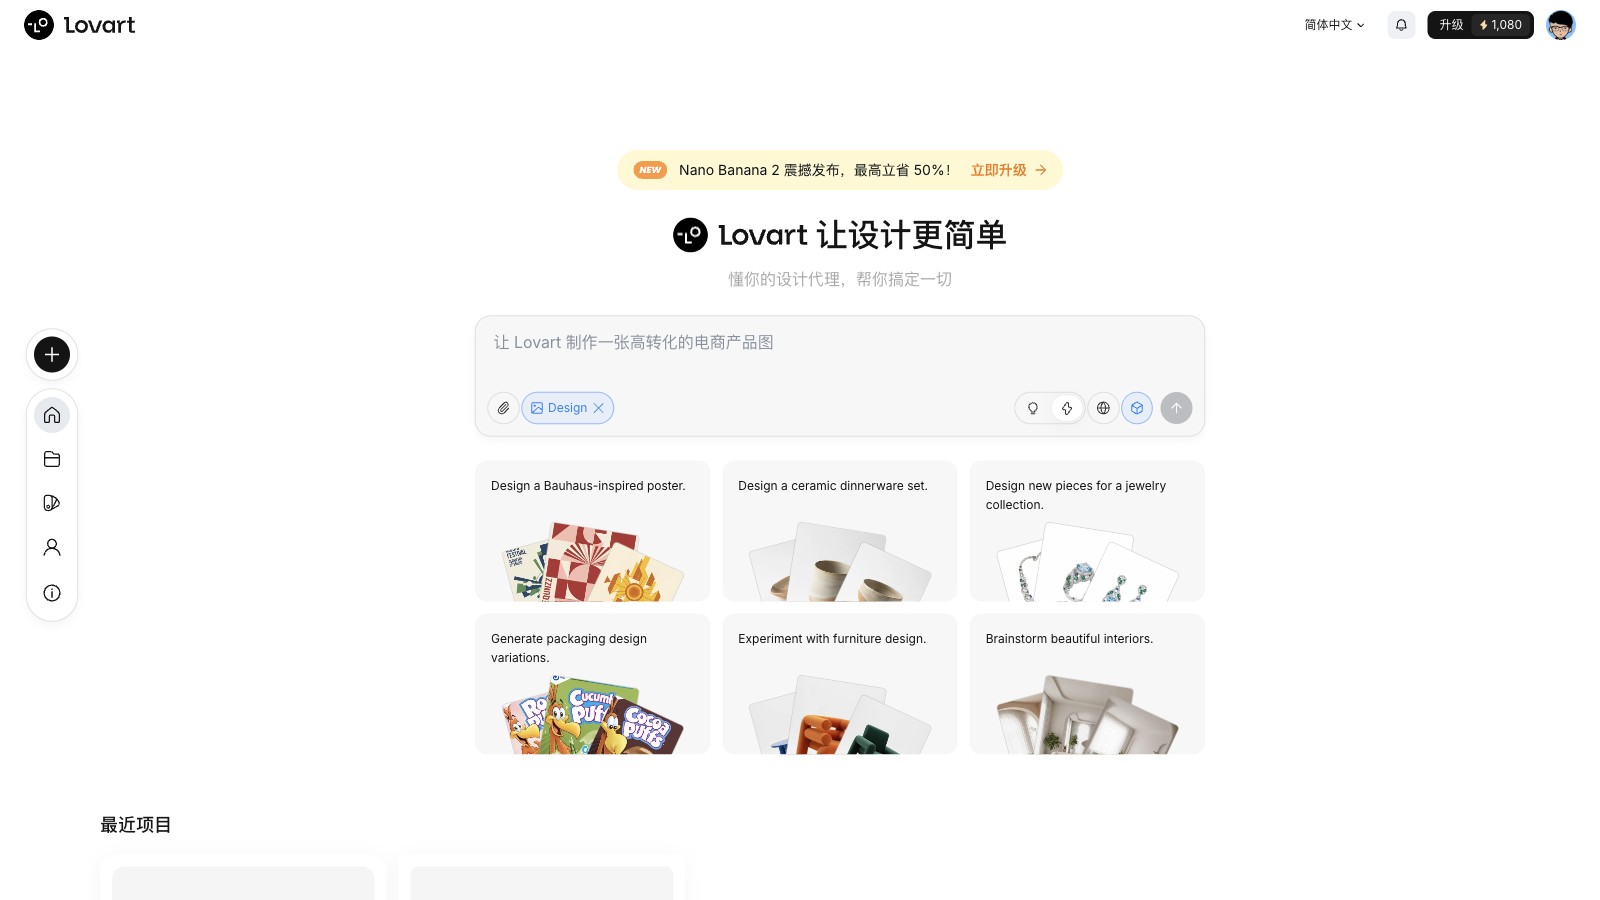
Lovart 是一款面向设计任务的 AI 智能体工具,用户只需用自然语言说明创意需求,系统便能从概念拆解一路推进到成品交付,省去在多个软件之间来回切换的麻烦。它把图像、视频、音频等多种内容形态的生成整合在同一套流程中,并借助对话式画布让设计过程更接近与真人设计师协作的体验。
平台会根据具体任务自动匹配相应的 AI 模型,兼顾写实渲染、艺术风格创作与复杂指令理解,生成结果以分层形式呈现,方便后续精修与复用。
主要功能
- 端到端设计执行:从创意拆解到成品输出由系统连贯完成,用户以自然语言下达需求即可,无需跨平台操作。
- 多形态内容生成:可产出高质量图像、动态视频与背景音乐等,并能把静态设计转化为带脚本、场景说明和配乐的 30 秒广告视频。
- 模型智能调度:依据任务类型自动选用合适的 AI 模型,例如以 Flux Pro 完成照片级写实渲染、以 Stable Diffusion 进行艺术风格创作、以 GPT-4 解析复杂创意指令。
- ChatCanvas 对话式画布:在无限画布上通过自然语言与 AI 协作,浏览、挑选并编辑多个设计方案,模拟与设计师实时配合的体验。
- 自动分层与二次编辑:生成内容自动按图层组织,支持类似 Photoshop 的局部重绘、颜色调整、文字间距修改等操作,并保留历史记录以便撤销。
- 批量生成与品牌一致性:一次可产出多达 40 个风格或布局不同的方案,并能搭建完整的品牌视觉识别系统,保证跨项目的视觉统一。
应用场景
- 品牌营销与广告创意:快速产出契合品牌调性的海报、社交媒体广告与宣传视频,批量生成不同尺寸和风格的广告变体,显著压缩传统品牌预算。
- 品牌视觉识别系统设计:从标志、色彩体系、字体搭配到应用规范整体构建 VI,系统会记住品牌偏好并在后续设计中延续,适合初创企业与品牌重塑。
- 电商产品视觉制作:生成产品展示图、包装设计与 3D 可视化内容,并可将静态产品图转为动态视频广告,帮助卖家快速产出专业素材。
- 内容创作与社交媒体运营:为创作者提供故事板、插画、缩略图与短视频的快速生成能力,支持多语言本地化,便于维持高频更新并适配各平台规格。
- 影视与动画预可视化:制作用于电影或动画项目的故事板、概念艺术与角色设计,借助 AI 唇形同步实现多语言配音与虚拟演员生成,降低前期成本、加快创意迭代。
- UI/UX 设计与产品原型:生成界面设计、应用图标与产品演示流程图等数字资产,支持响应式预览,确保不同屏幕尺寸下的显示一致性。